

五个本地引擎,短样本即可克隆
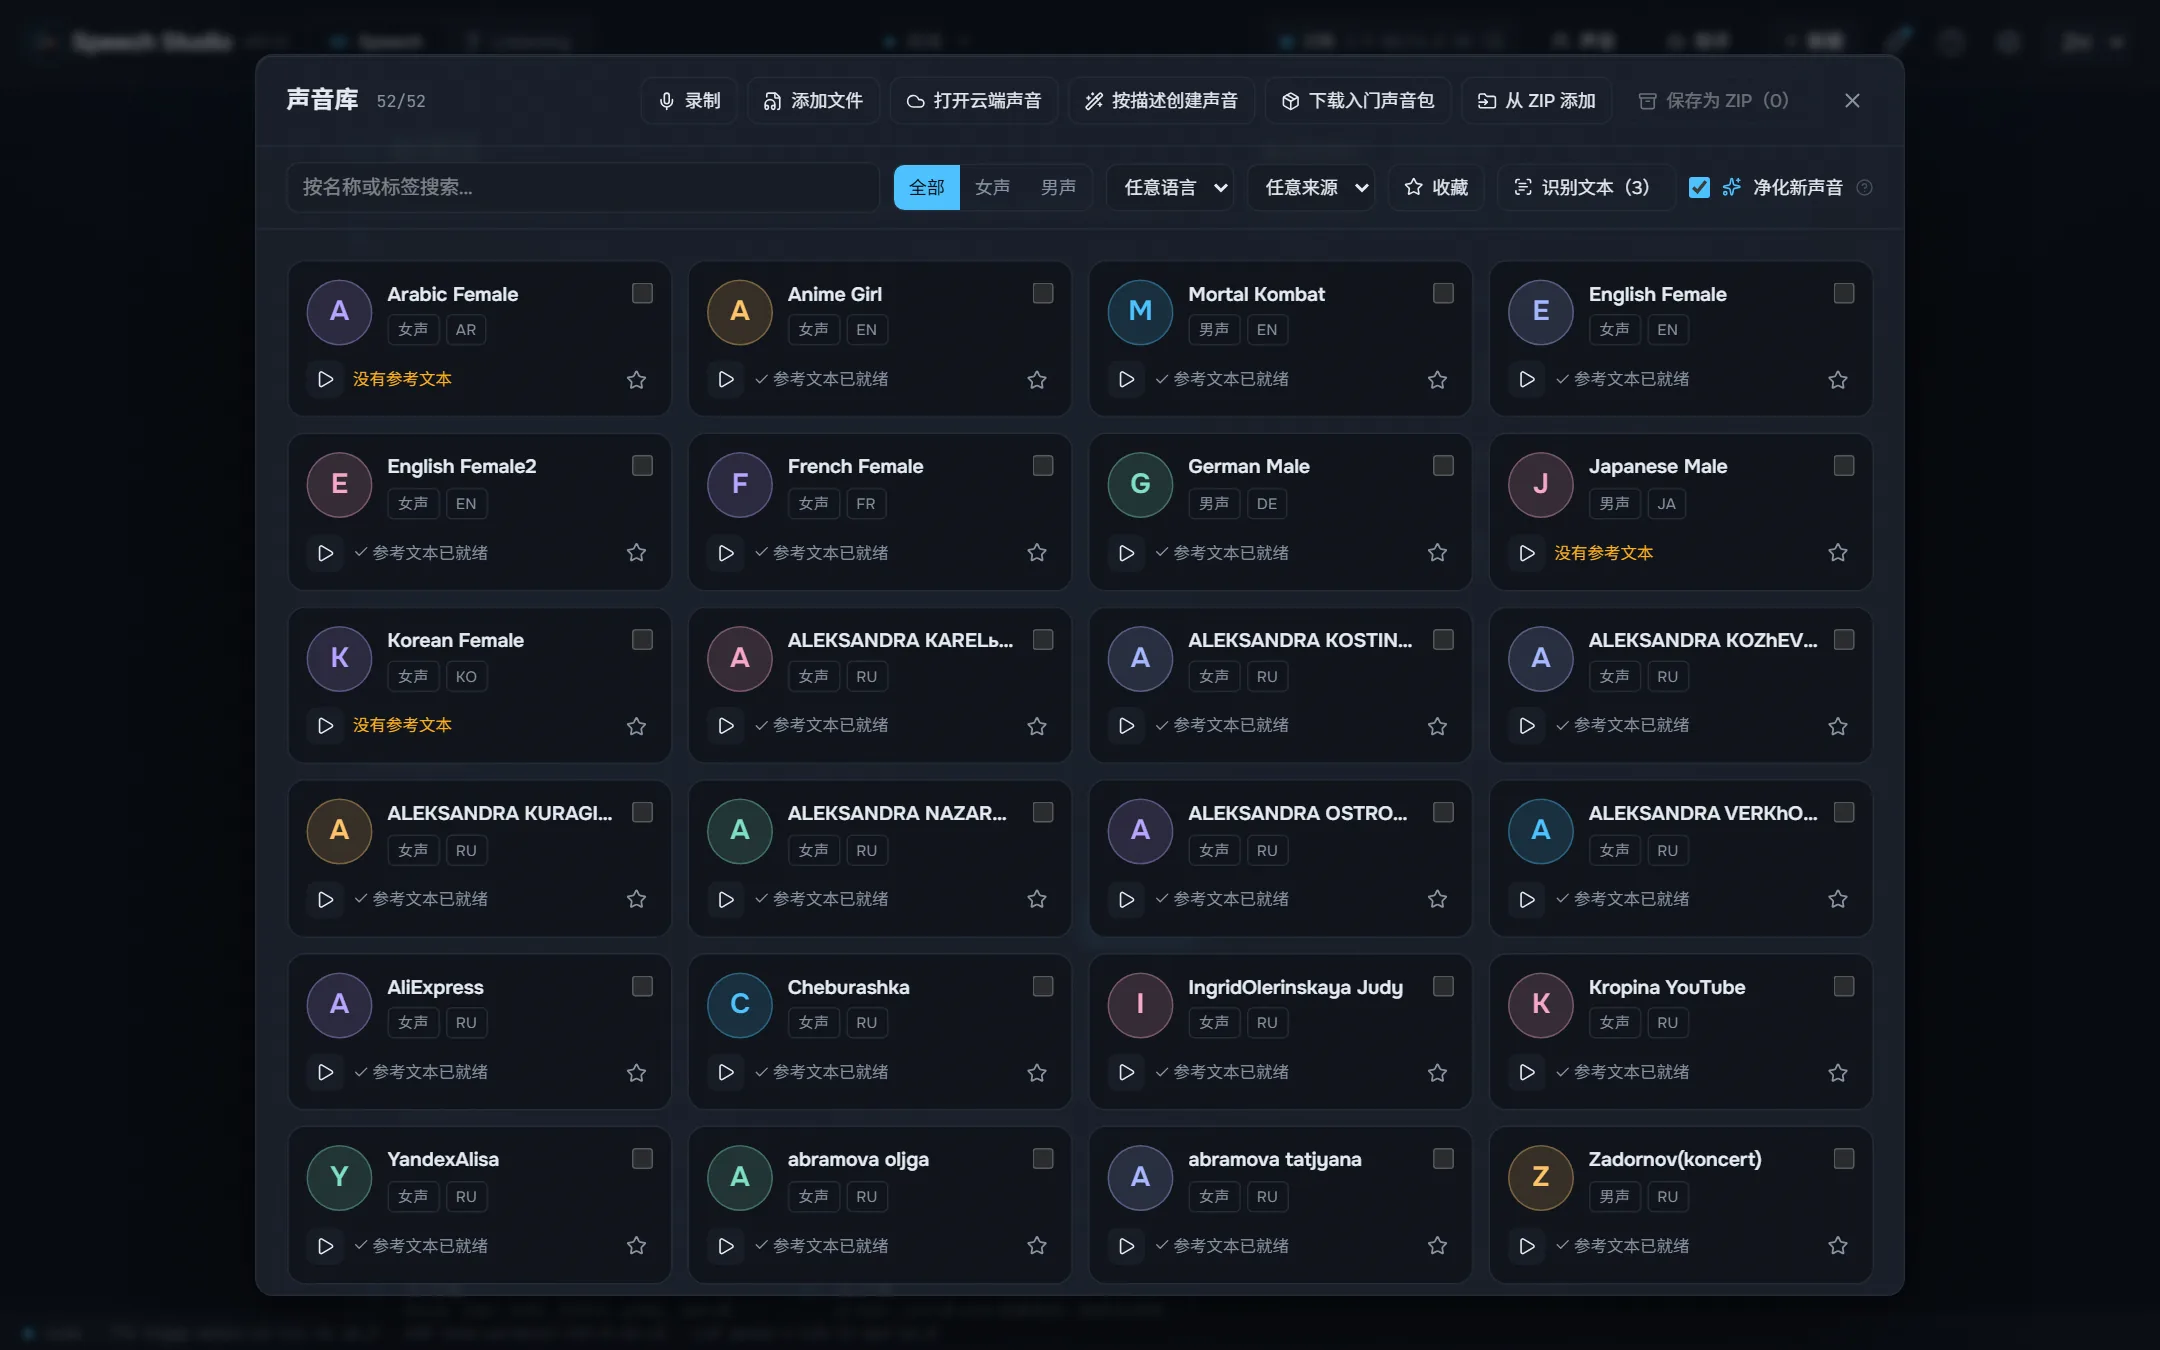
Higgs Audio v3、Fish Audio Drama 3、Supertonic 3、Qwen3-TTS 以及带俄语重音的 Qwen3-TTS 在你的显卡上运行。
一个桌面工作室:用五个本地引擎为文本配音,并把录音还原成带说话人的文字。
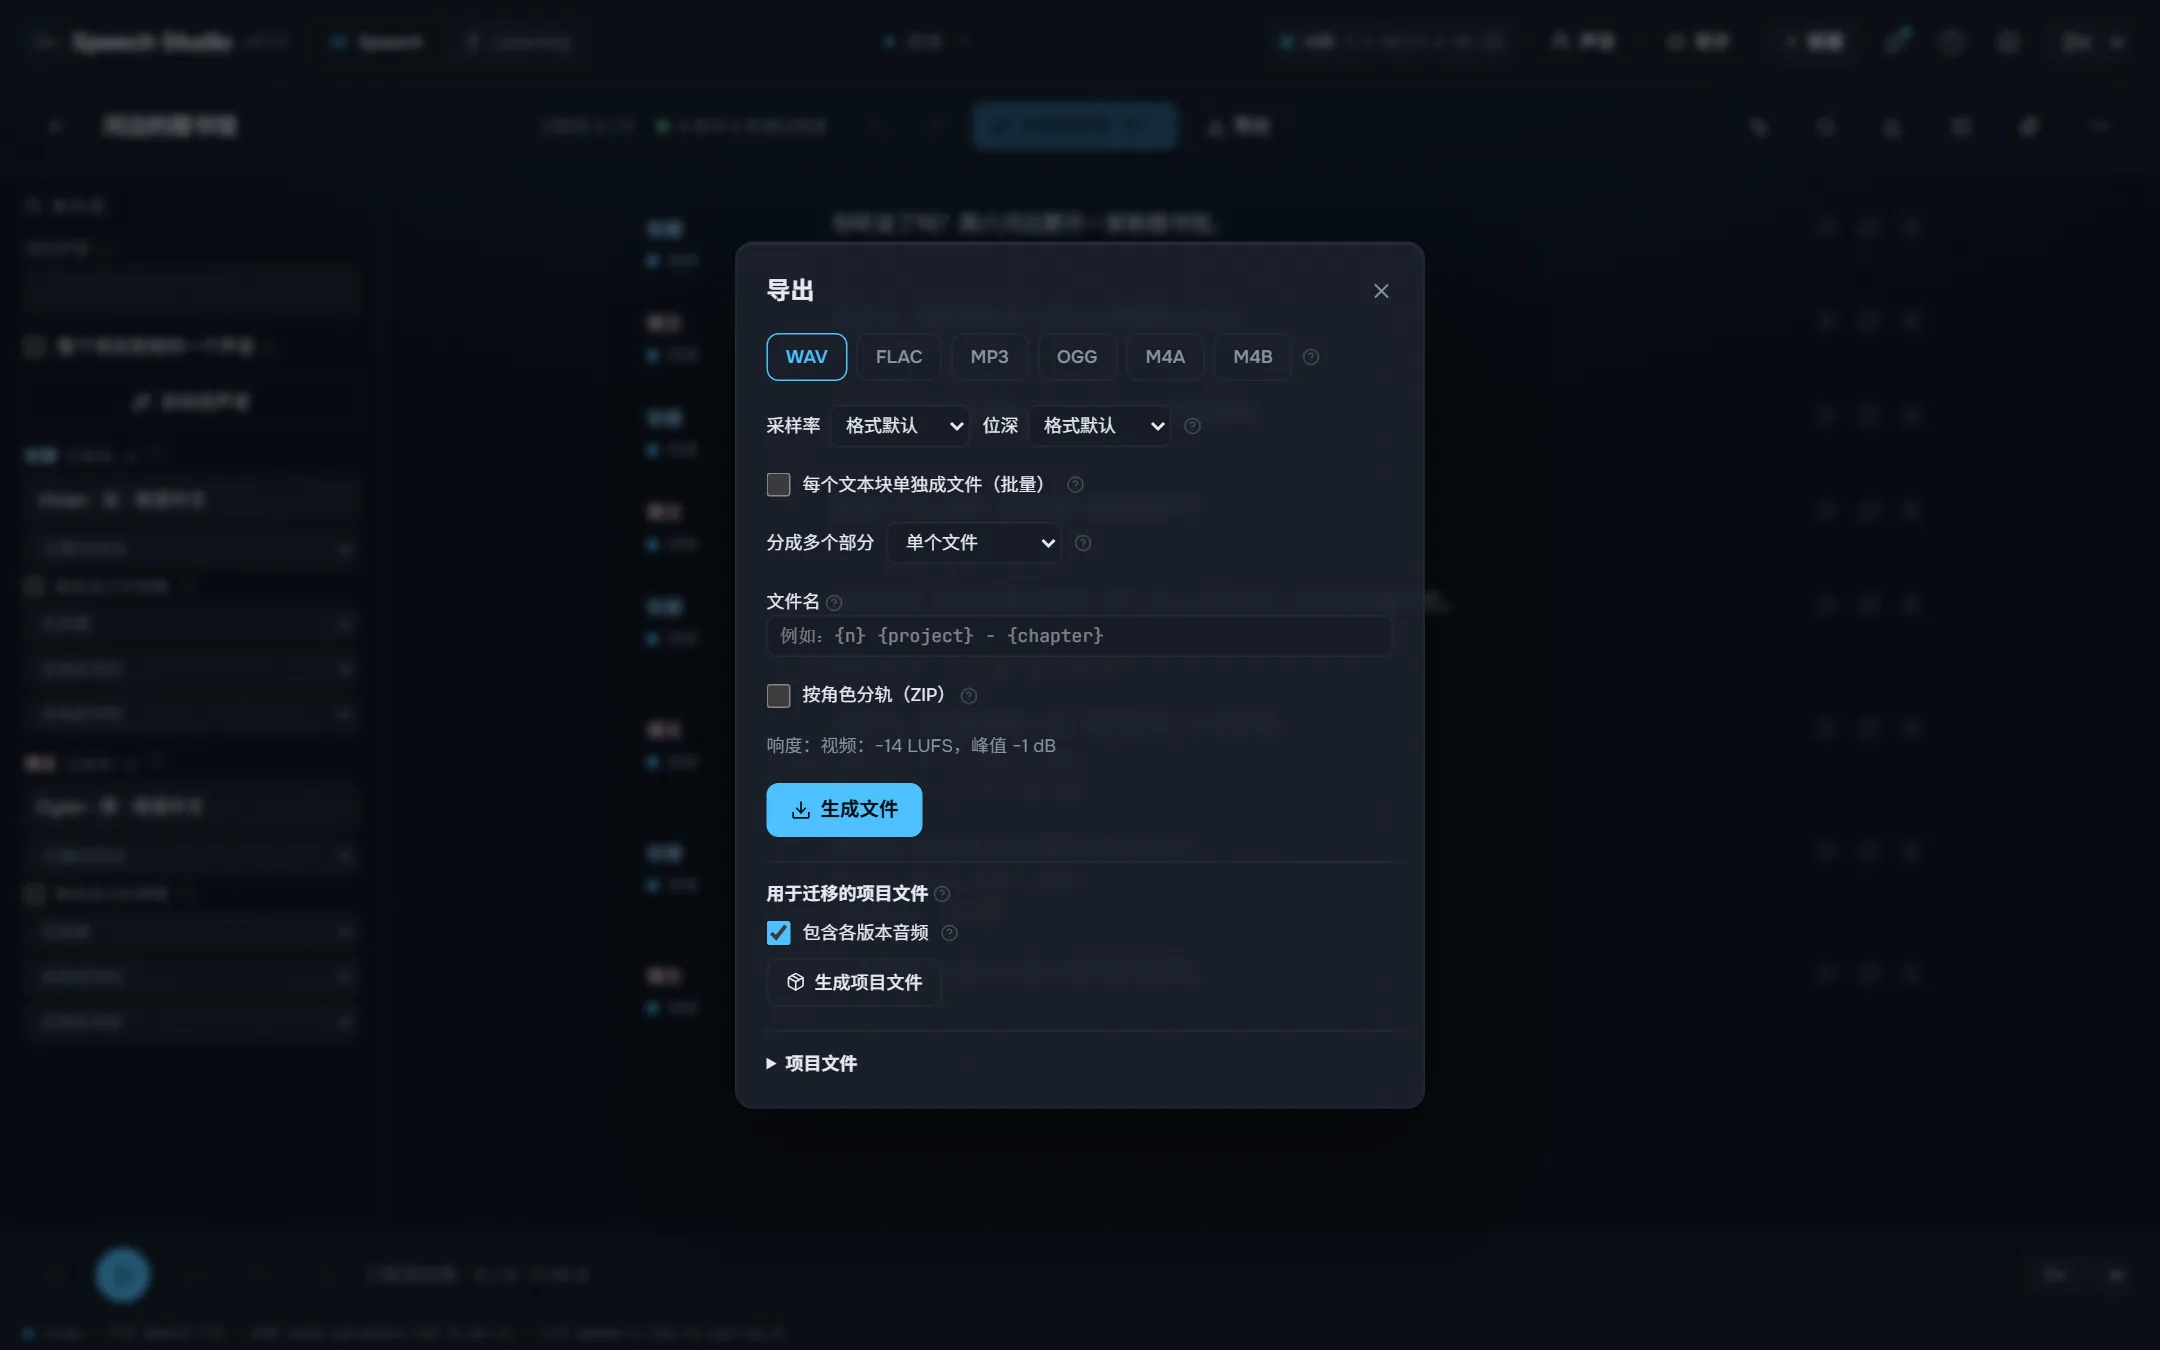
Windows 10/11 x64 和一块 8 GB 显存的 NVIDIA 显卡。模型和引擎在工作室内下载,由你决定何时下载。
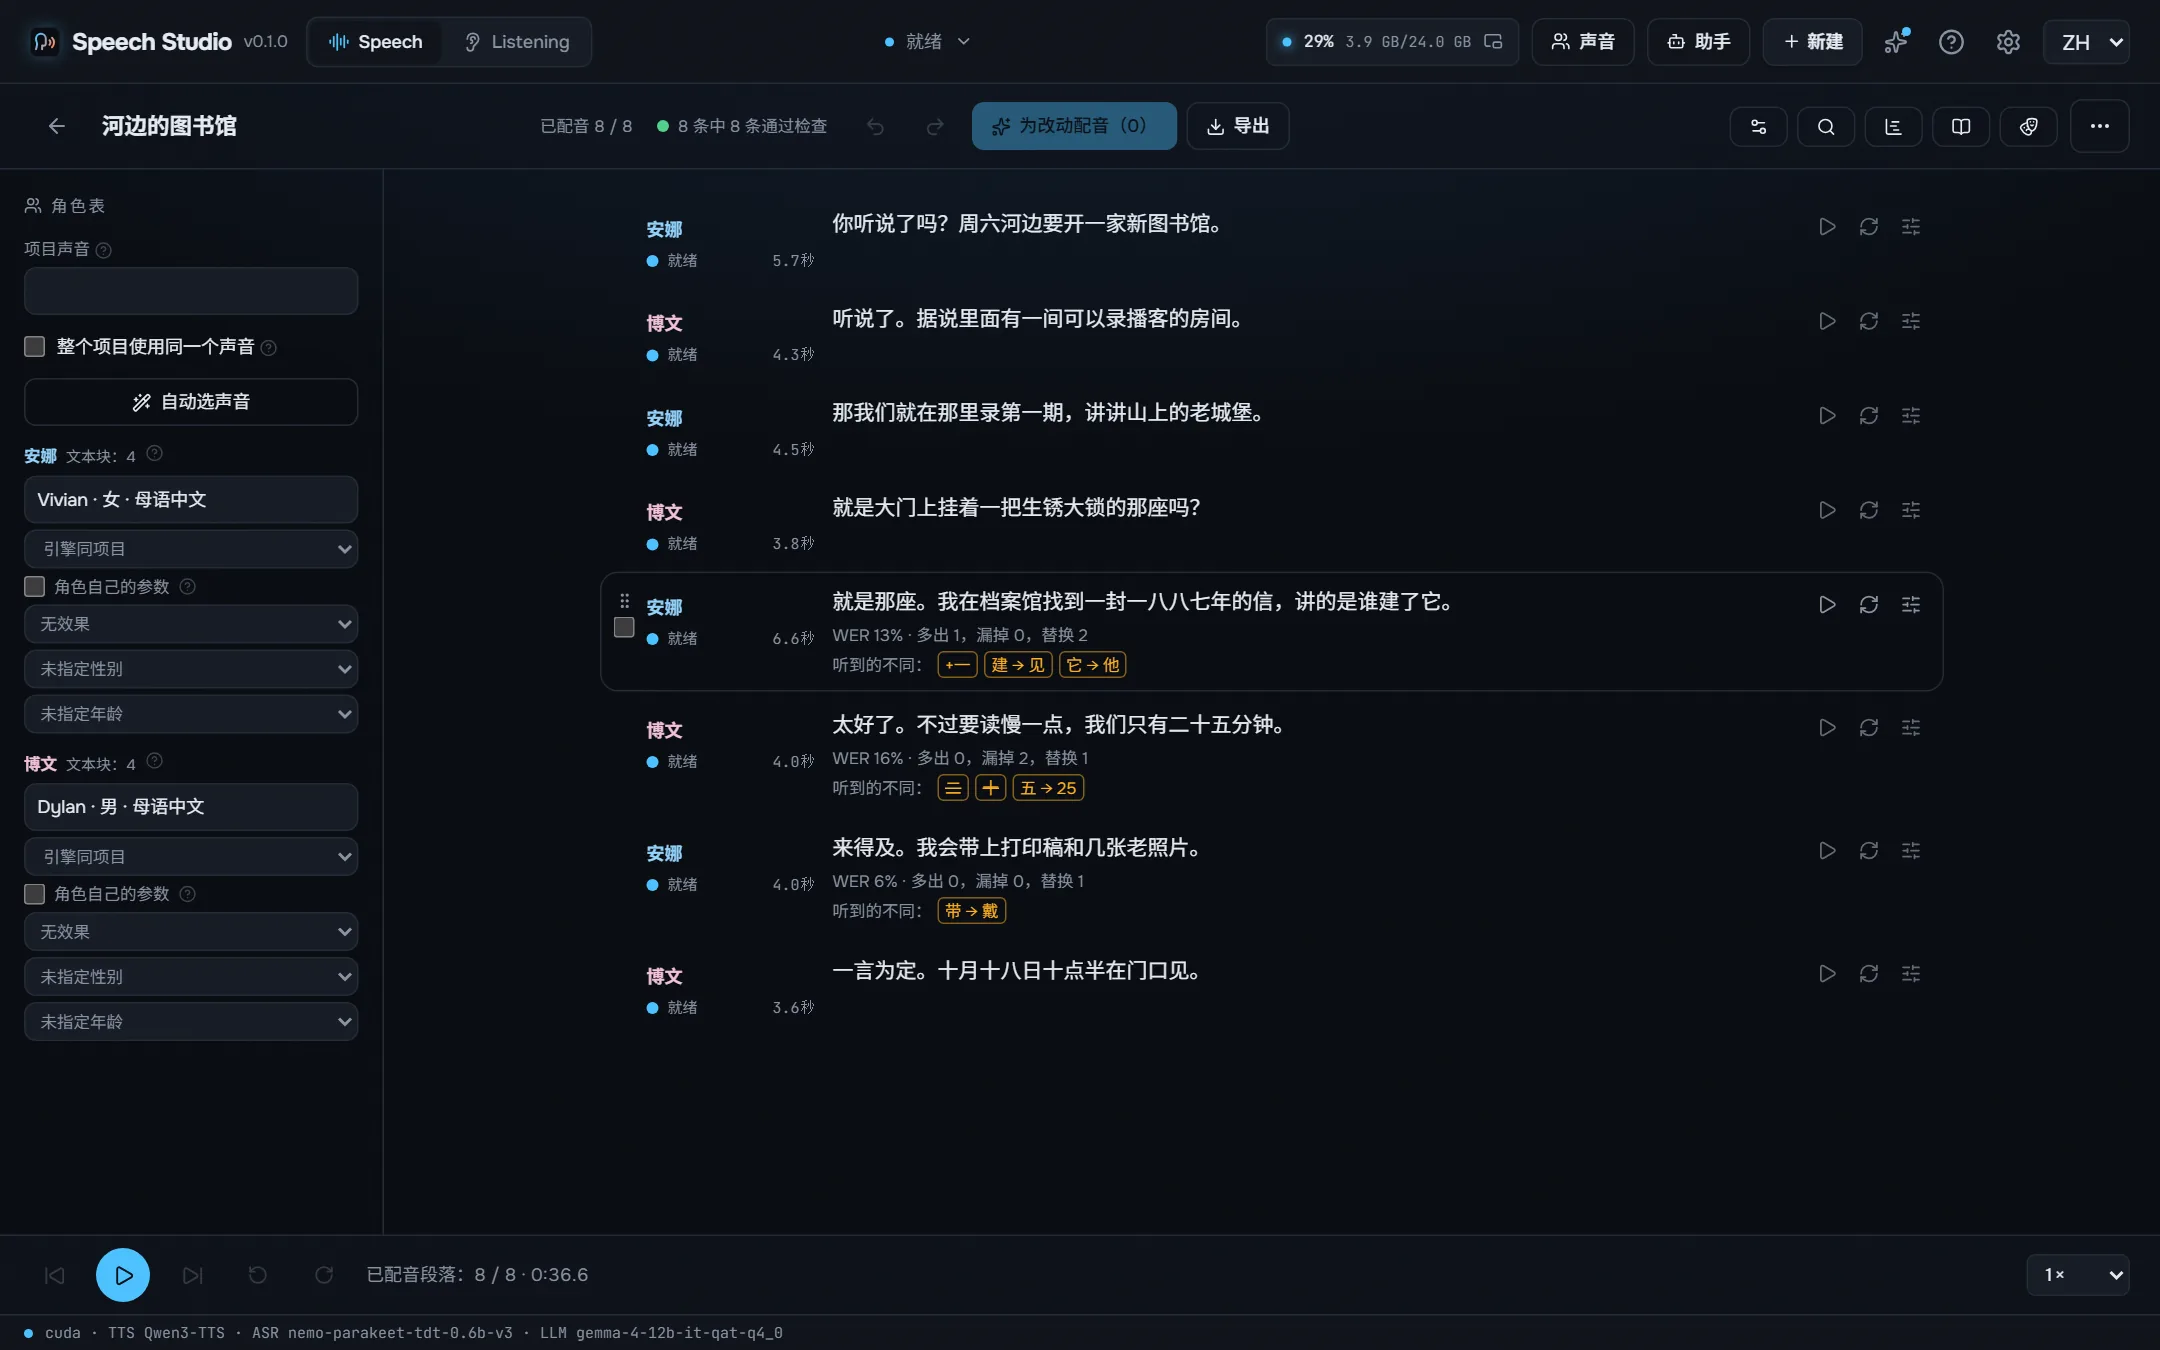
在这台电脑上用发行版工作室制作,每条录音都经过听写检查,并按工作室保存的样子导出。所有引擎朗读同一段文本。
床前明月光,疑是地上霜。举头望明月,低头思故乡。
Я помню чудное мгновенье — передо мной явилась ты, как мимолётное виденье, как гений чистой красоты.
Встреча 12.03 в 18:30, билет стоит 150 руб., а на улице −5 °C.
Shall I compare thee to a summer's day? Thou art more lovely and more temperate: rough winds do shake the darling buds of May, and summer's lease hath all too short a date.
¿Qué es poesía?, dices mientras clavas en mi pupila tu pupila azul. ¿Qué es poesía? ¿Y tú me lo preguntas? Poesía… eres tú.
Il pleure dans mon cœur comme il pleut sur la ville ; quelle est cette langueur qui pénètre mon cœur ?
Amor é fogo que arde sem se ver, é ferida que dói, e não se sente; é um contentamento descontente, é dor que desatina sem doer.
名人的声音是合成的:用工作室声音包里的一段短样本克隆而成,并非这些人的录音。诗歌属于公有领域。
Supertonic 3 和 Qwen3-TTS 的俄语重音靠猜。工作室在引擎朗读之前标好重音:RUAccent 根据句子选择 замо́к 还是 за́мок、му́ки 还是 муки́,数字、日期和单位按正确的格写成单词。
Старинный замок стоял на холме, а дверь в него запирали на тяжёлый замок. Из этой муки пекут хлеб, но для пекаря это настоящие муки.
Мы долго стояли у берега и смотрели, как белки прыгают по веткам. В яйце много белка, а в этой задаче много лишних белков.
测试环境:RTX 4090、Windows 11,安装版 Speech Studio 0.2.0;同一段 17 秒的俄语文本,每个引擎第二次运行(模型已加载)。首个声音指窗口中开始出声的时间;显存为朗读时的峰值。
| 引擎 | 用途 | 比实时快 | 首个声音 | 流式 | 下载 | 显存 |
|---|---|---|---|---|---|---|
| Supertonic 3 | 最快,固定音色,不支持克隆 | 168× | 103 毫秒 | 按句 | 0.1 GB | 1.0 GB |
| Qwen3-TTS | 快速,预设音色与克隆 | 12× | 19 毫秒 | 边说边出 | 2.2 GB | 3.1 GB |
| Qwen3-TTS + ru stress LoRA | 俄语重音准确,克隆 | 10× | 26 毫秒 | 边说边出 | 2.3 GB | 3.5 GB |
| Fish Audio Drama 3 | 表演与音质最佳,克隆;6 GB 显存起 | 7.0× | 326 毫秒 | 边说边出 | 21.4 GB | 21.9 GB |
| Higgs Audio v3 | 用标签控制情绪与音效,克隆 | 2.3× | 1.0 秒 | 边说边出 | 5.3 GB | 18.1 GB |
同一台电脑、安装版 Speech Studio 0.2.1 (Whisper 0.2.4):在 Listening 中识别同一段 5 分钟单人俄语录音(不区分说话人),含模型加载时间。× 表示比录音时长快多少倍;显存为任务期间的峰值,任务结束后模型会释放显存。
| 模型 | 用途 | 显卡 | 处理器 | 语言数 | 下载 | 显存 |
|---|---|---|---|---|---|---|
| Parakeet TDT v3 | 快速准确,自动判断语言 | 96× | 33× | 25 | 0.7 GB | 1.2 GB |
| Parakeet Ultra | Moondream 微调的 Parakeet:识别错误更少 | 73× | 33× | 25 | 0.7 GB | 1.0 GB |
| Nemotron 3.5 | 可指定语言,不会混入其他语言的词 | 73× | 29× | 28 | 0.7 GB | 1.0 GB |
| Whisper large-v3-turbo | 支持的语言最多 | 19× | 2.2× | 99 | 1.6 GB | 1.6 GB |
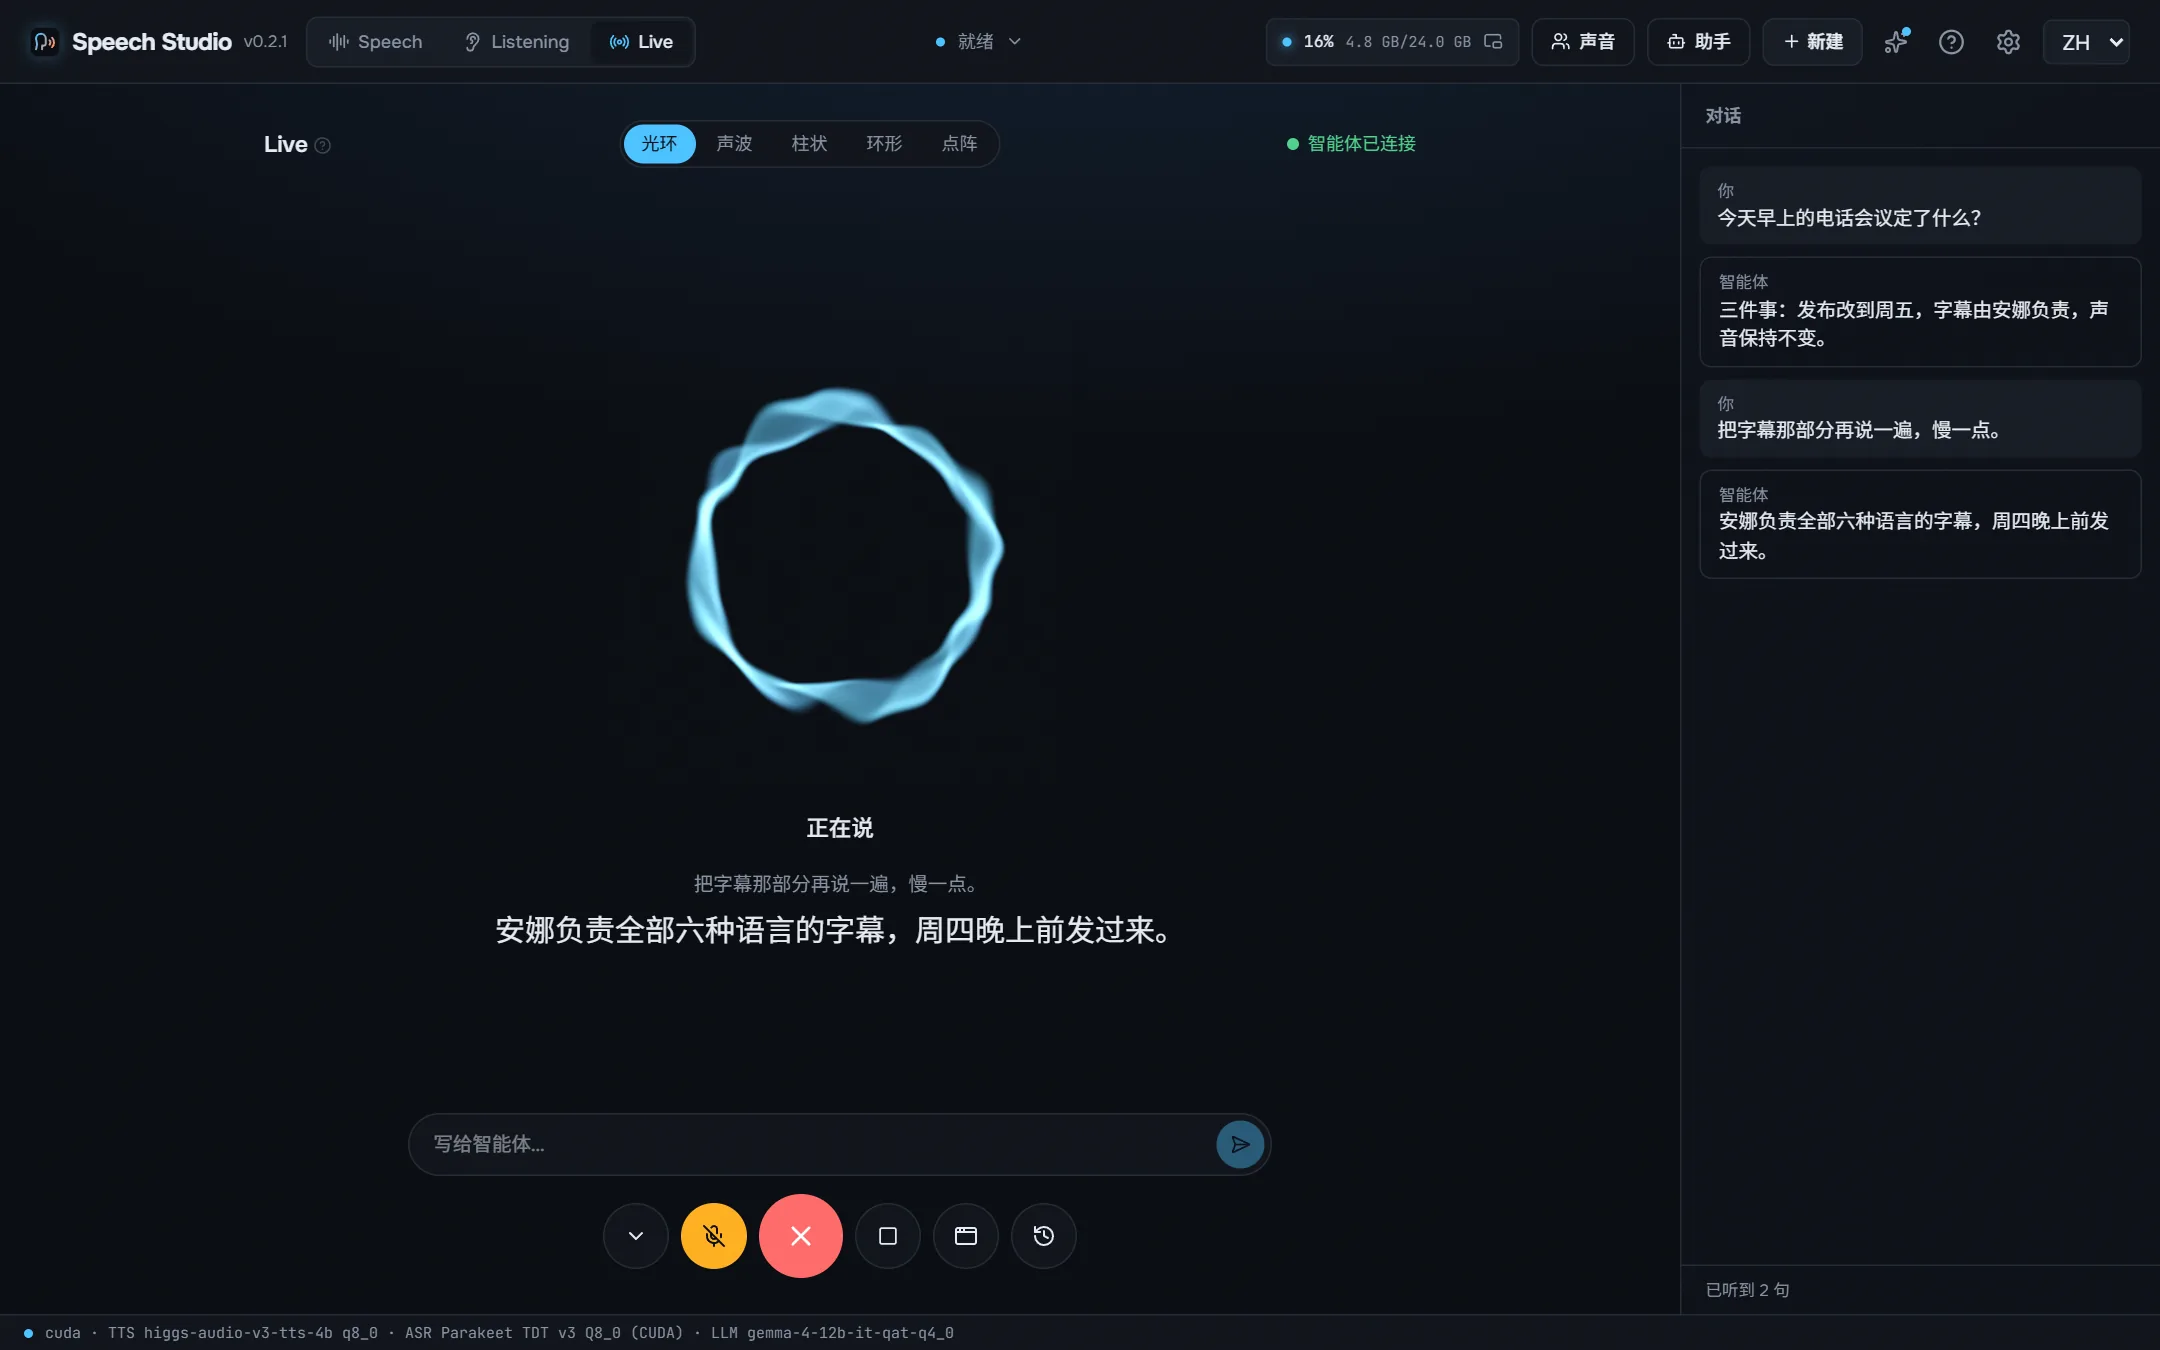
对话中一个来回的每一步,在同一台电脑上测得。最耗时的是智能体自己的思考,取决于智能体及其模型。
| 你说完后,这句话变成文字(显卡上的 Parakeet,含判定说完的停顿) | 641 毫秒 – 735 毫秒 |
| 智能体写出回答(Claude Sonnet,实测) | 2.0 秒 – 3.9 秒 |
| 回答的首个声音(按引擎,见上表) | 19 毫秒 – 1.0 秒 |
Higgs Audio v3、Fish Audio Drama 3、Supertonic 3、Qwen3-TTS 以及带俄语重音的 Qwen3-TTS 在你的显卡上运行。
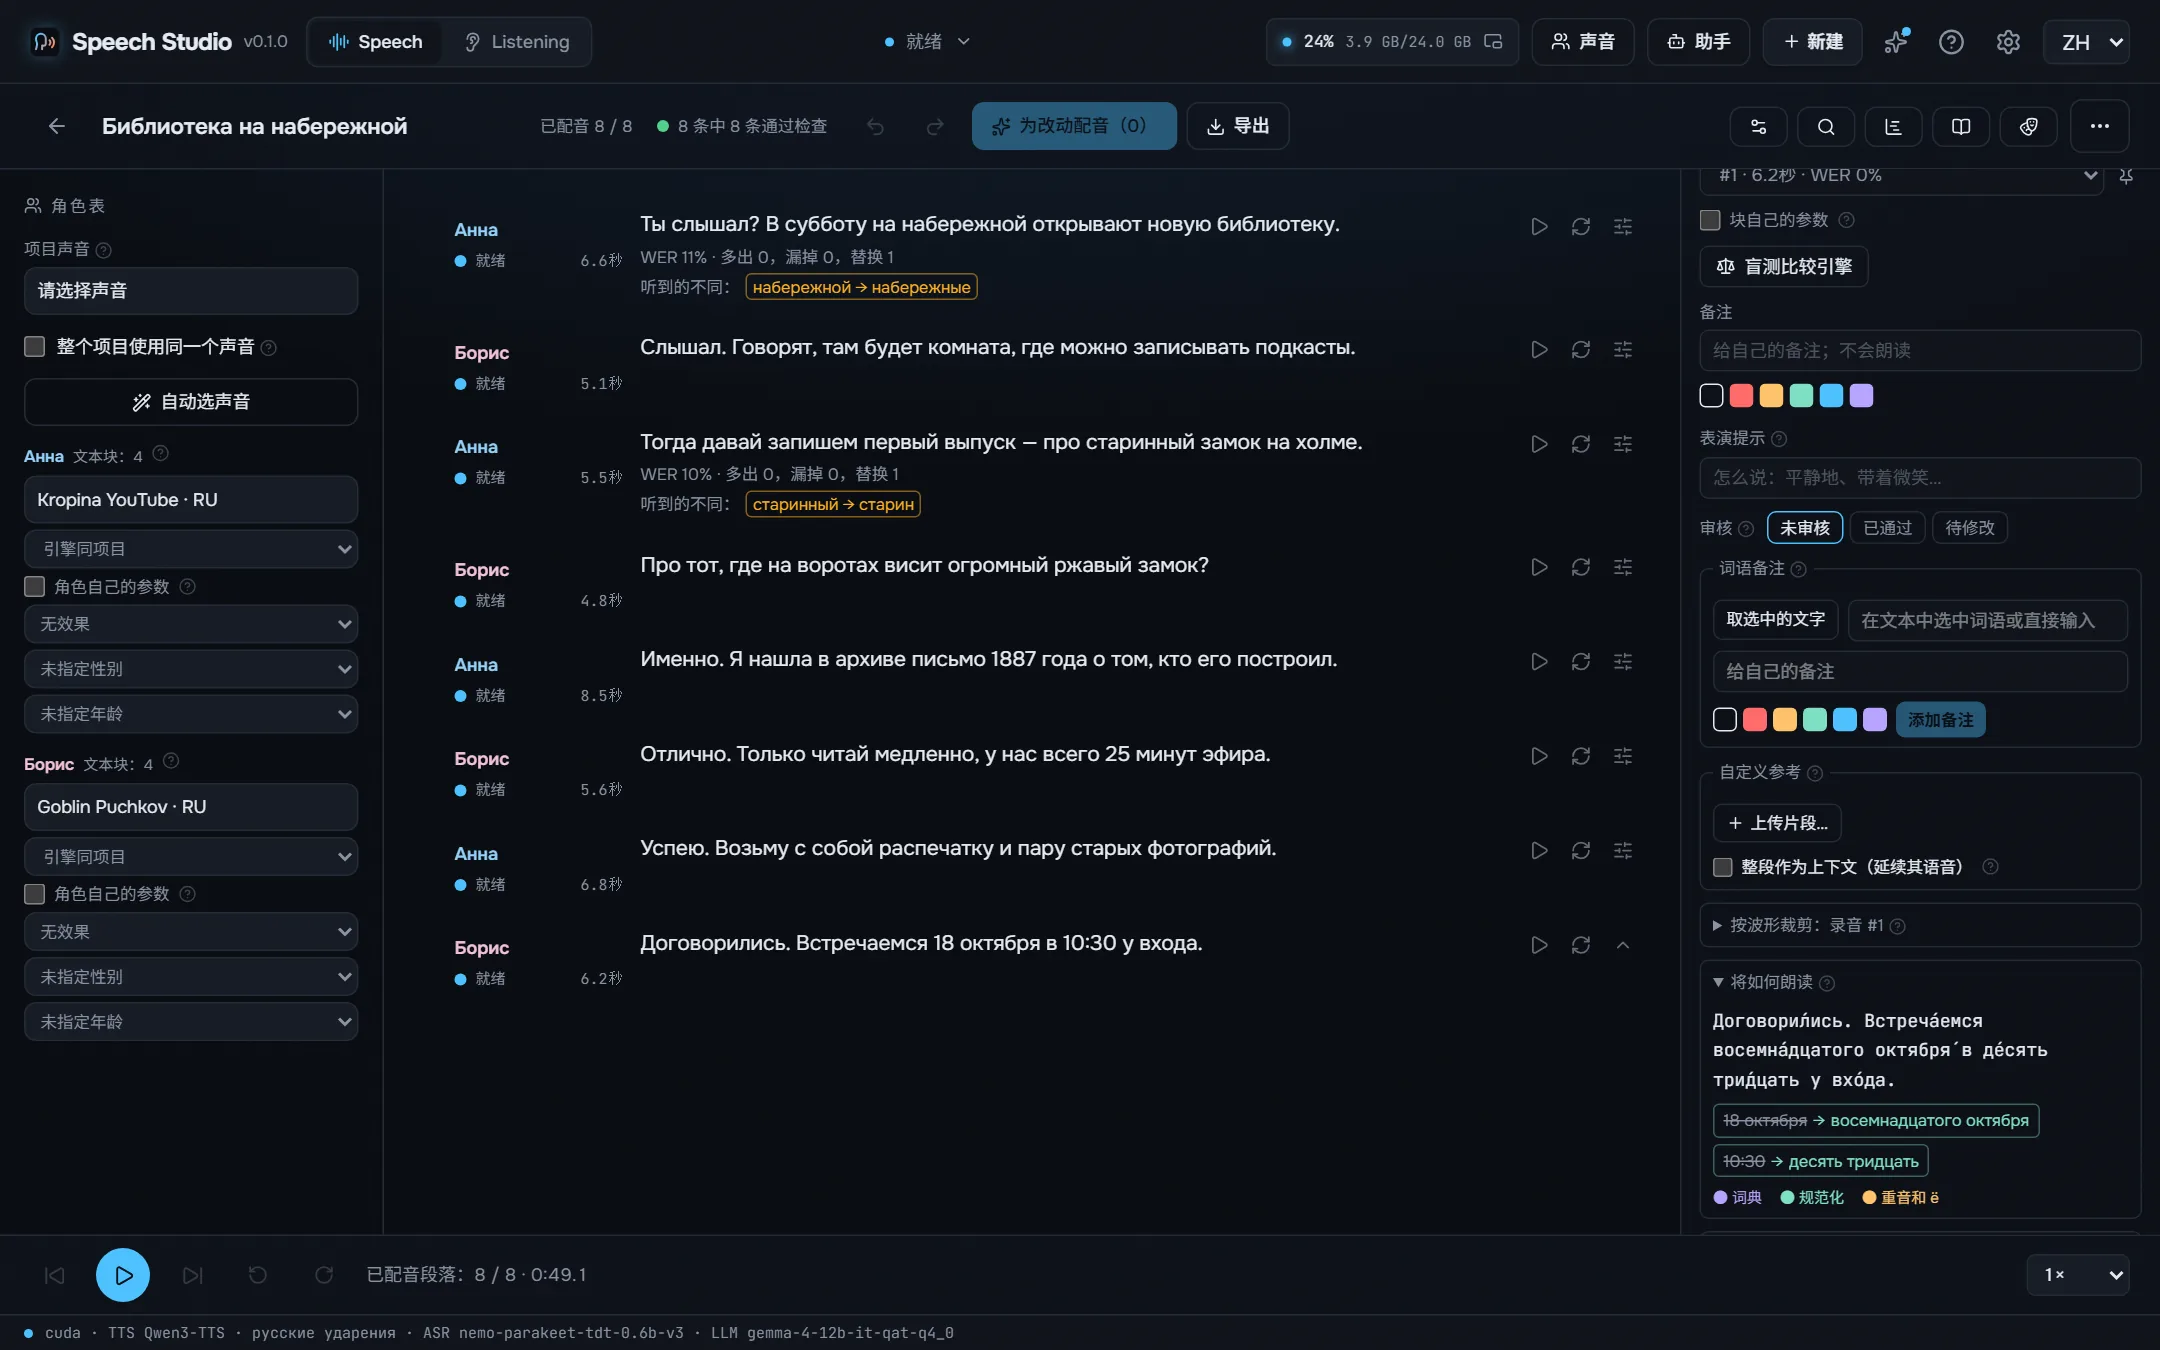
数字按正确的格和性、日期、时间、金额和单位在引擎朗读前写成单词。
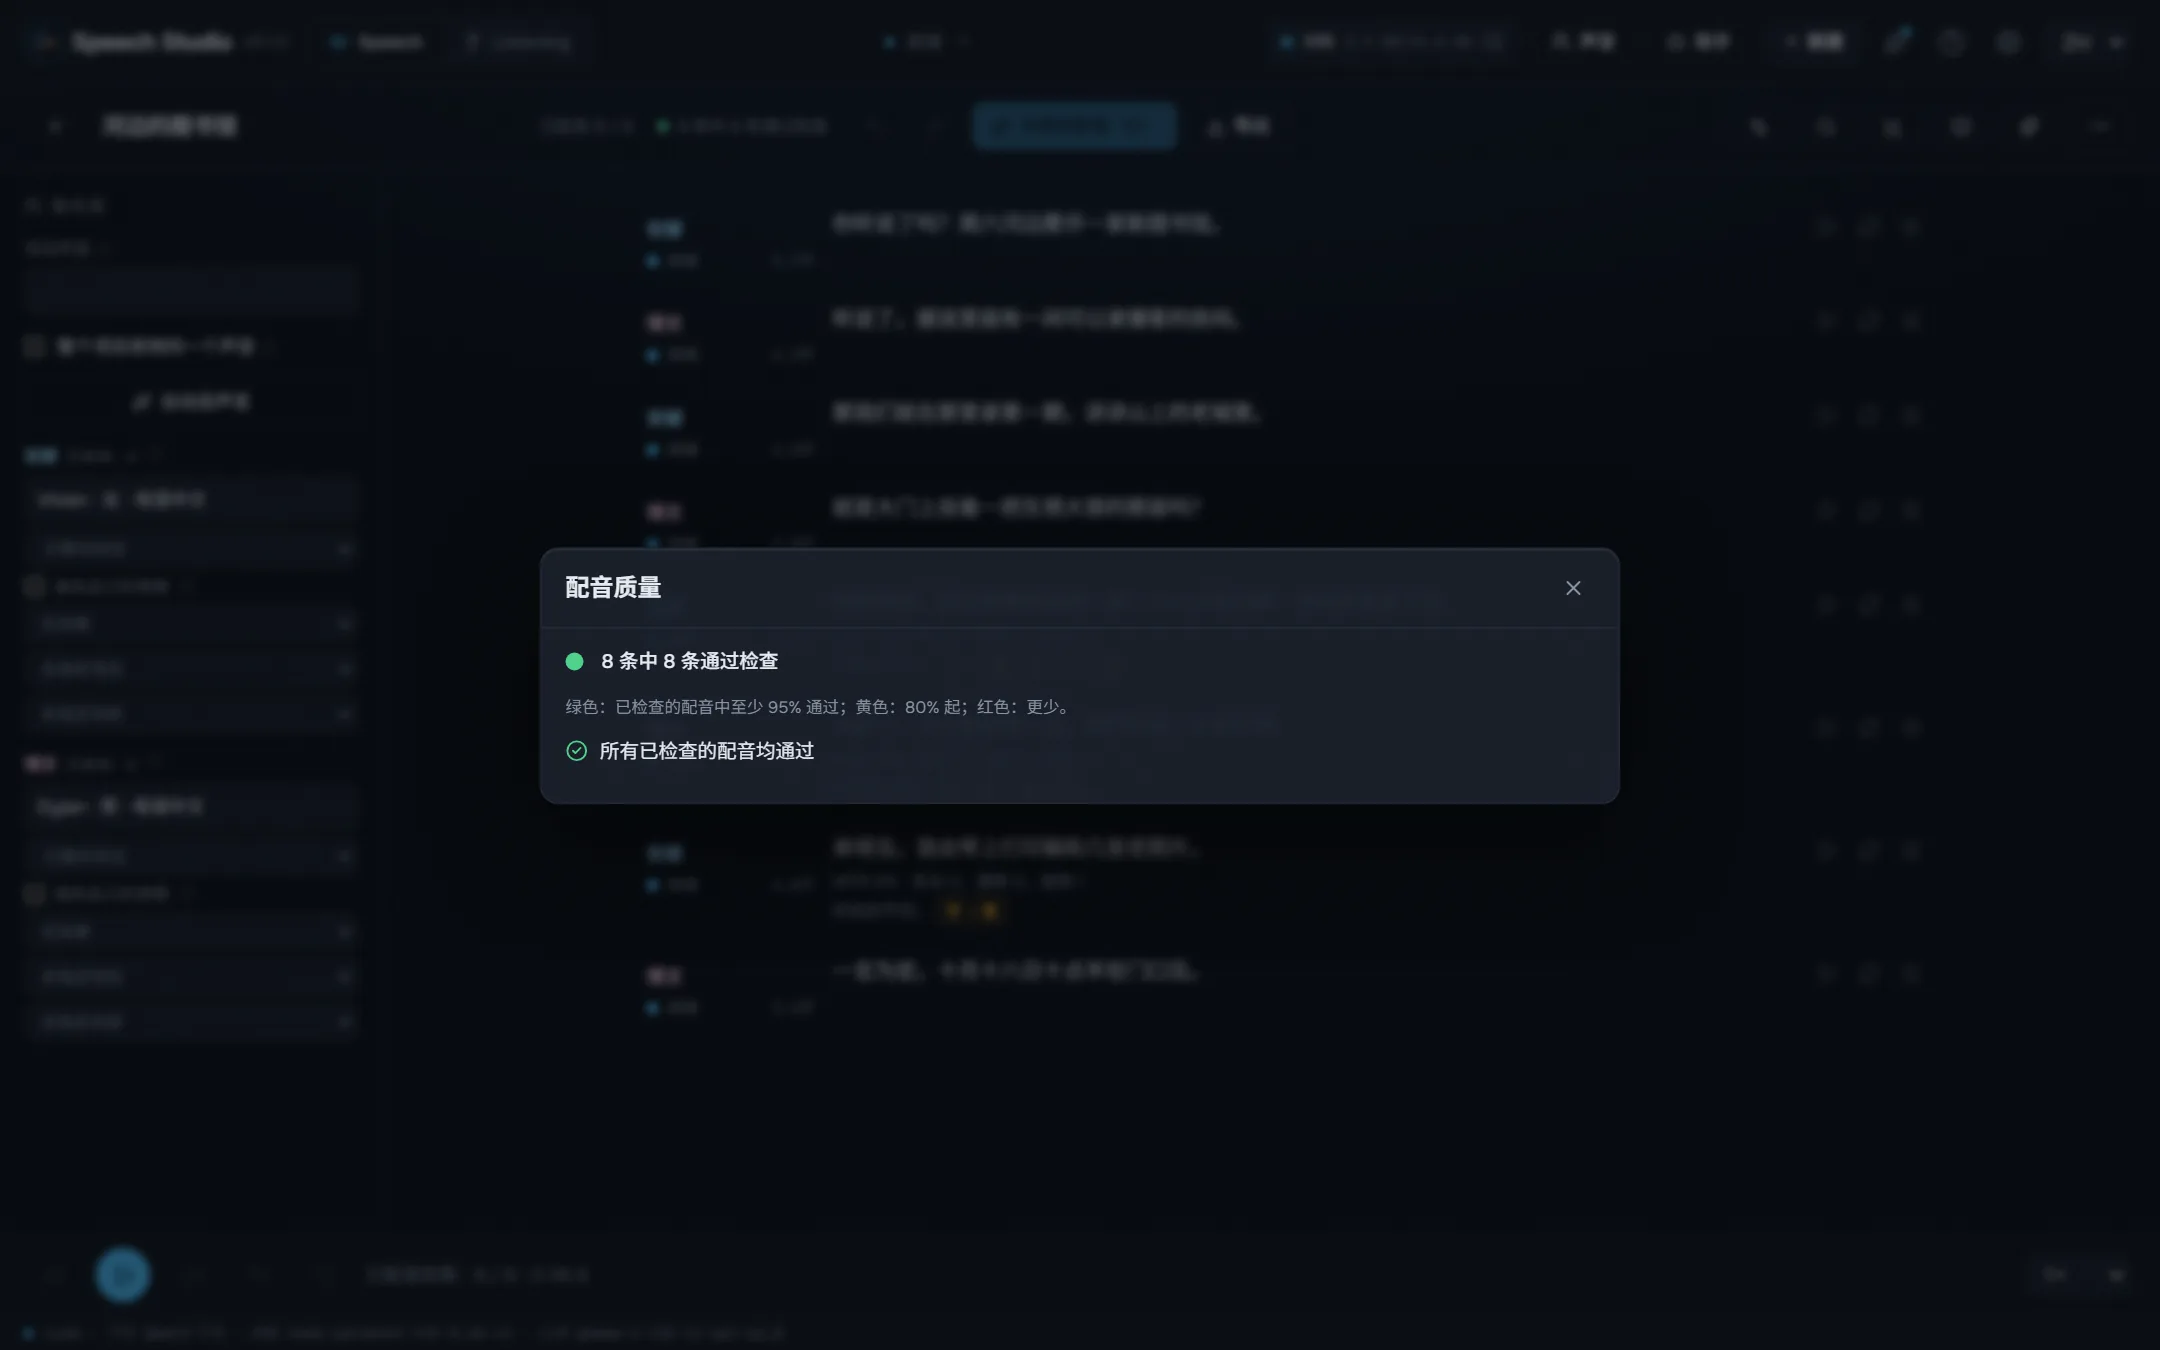
每条录音都会被识别回文字并与文本逐词比对,并检查削波、静音、截断、咔哒声、重复短语以及噪声代替语音。
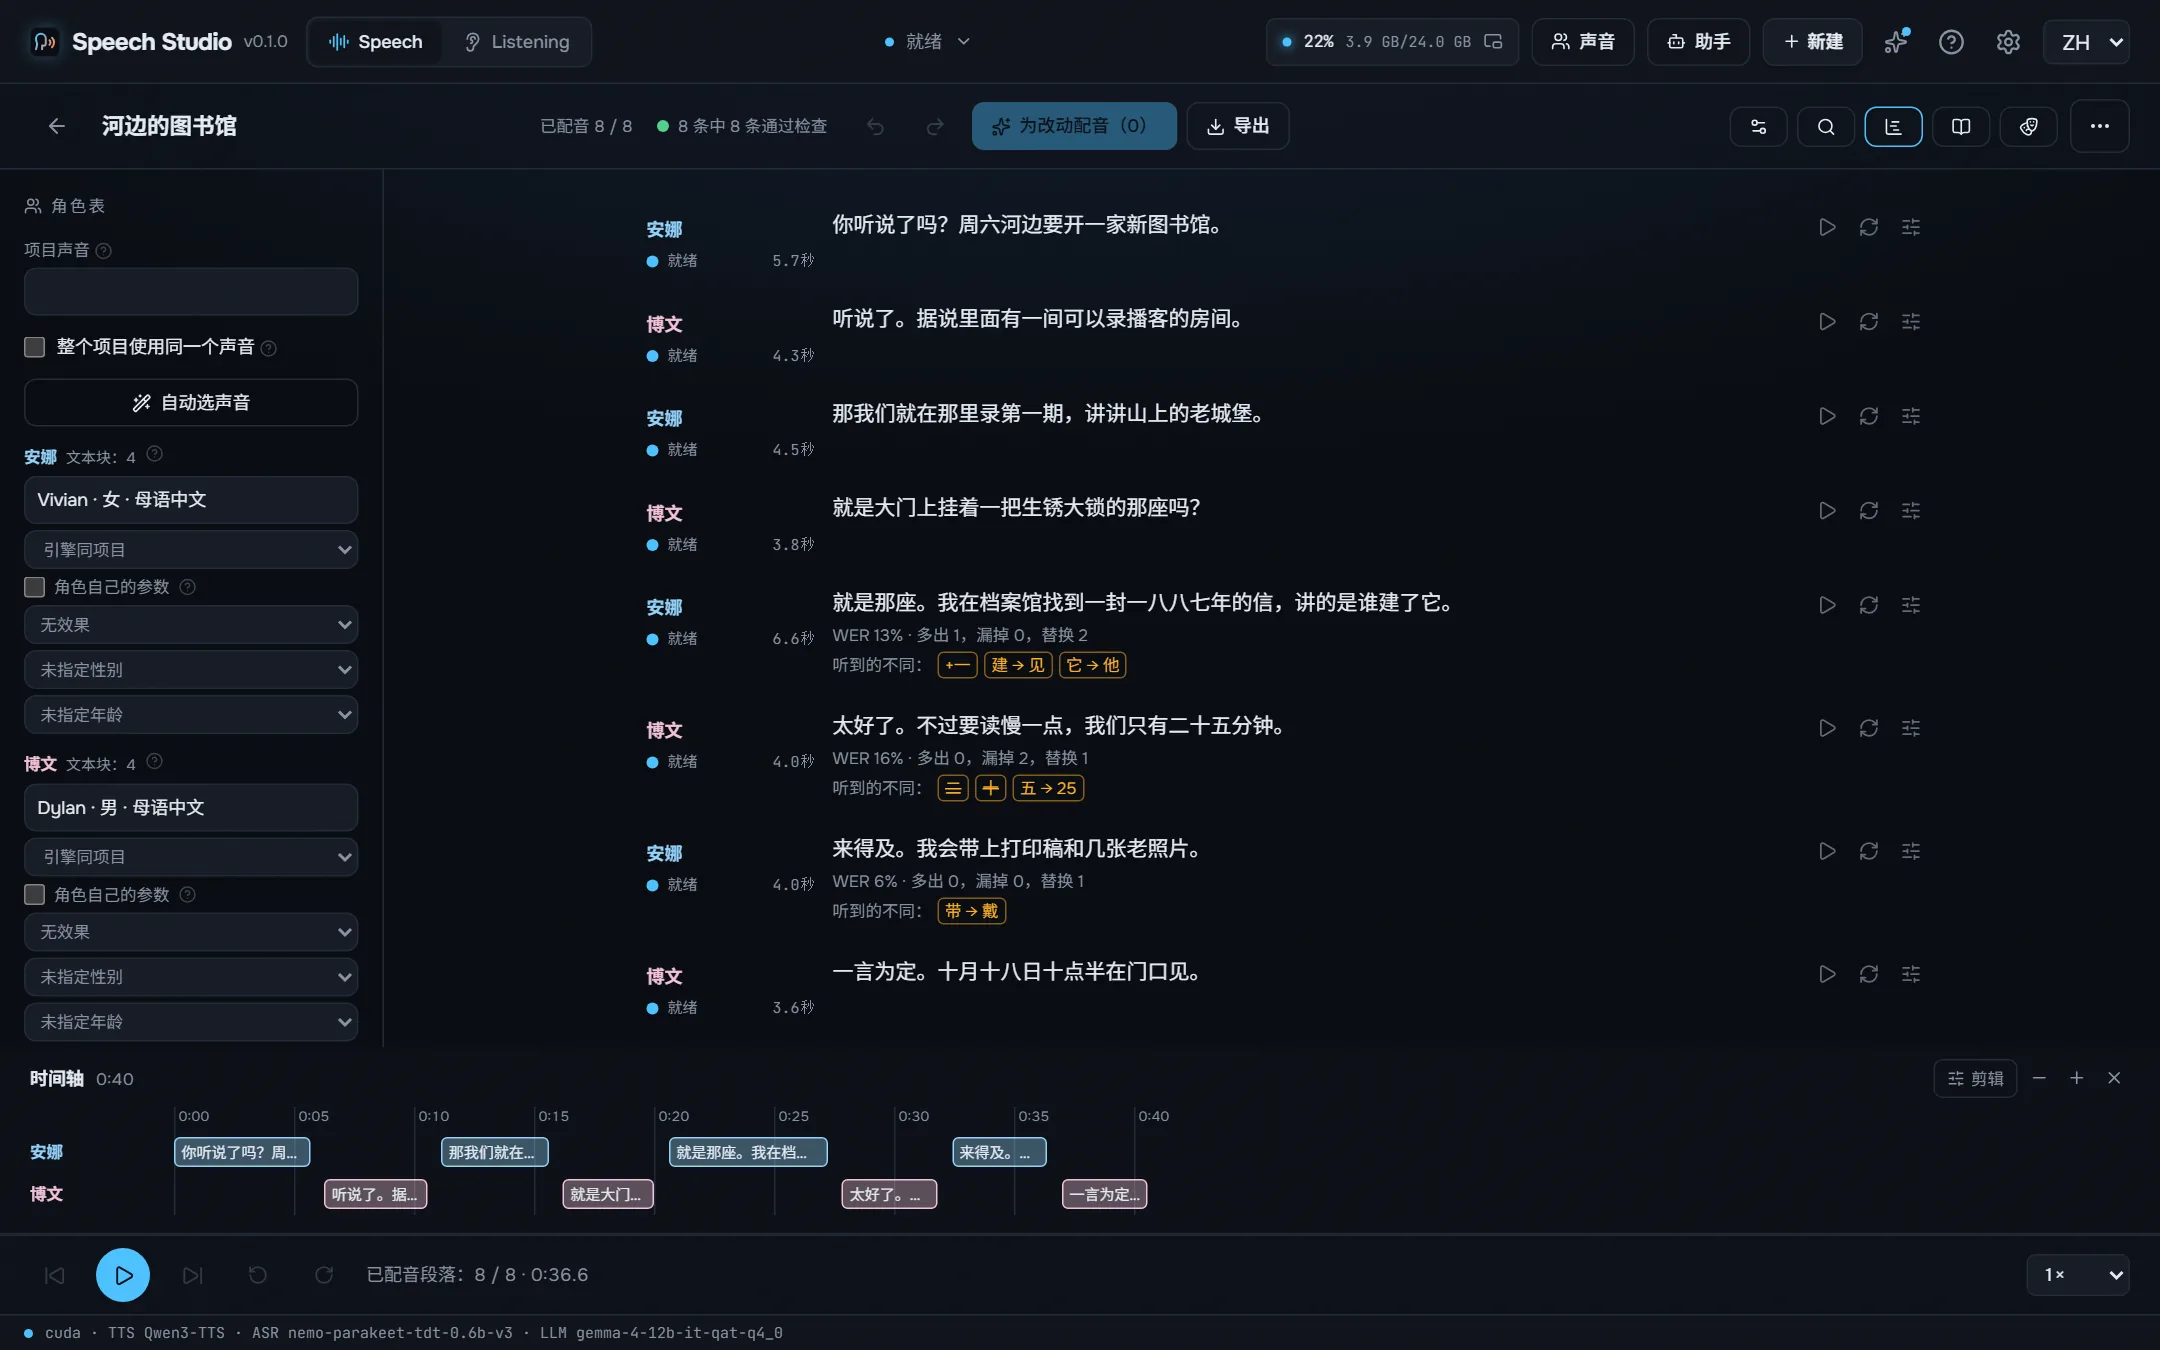
«Anna:» 和 «[Anna]» 行会变成拥有各自声音的角色,导演按主题为多个声音写播客,时间线显示每一处重叠。
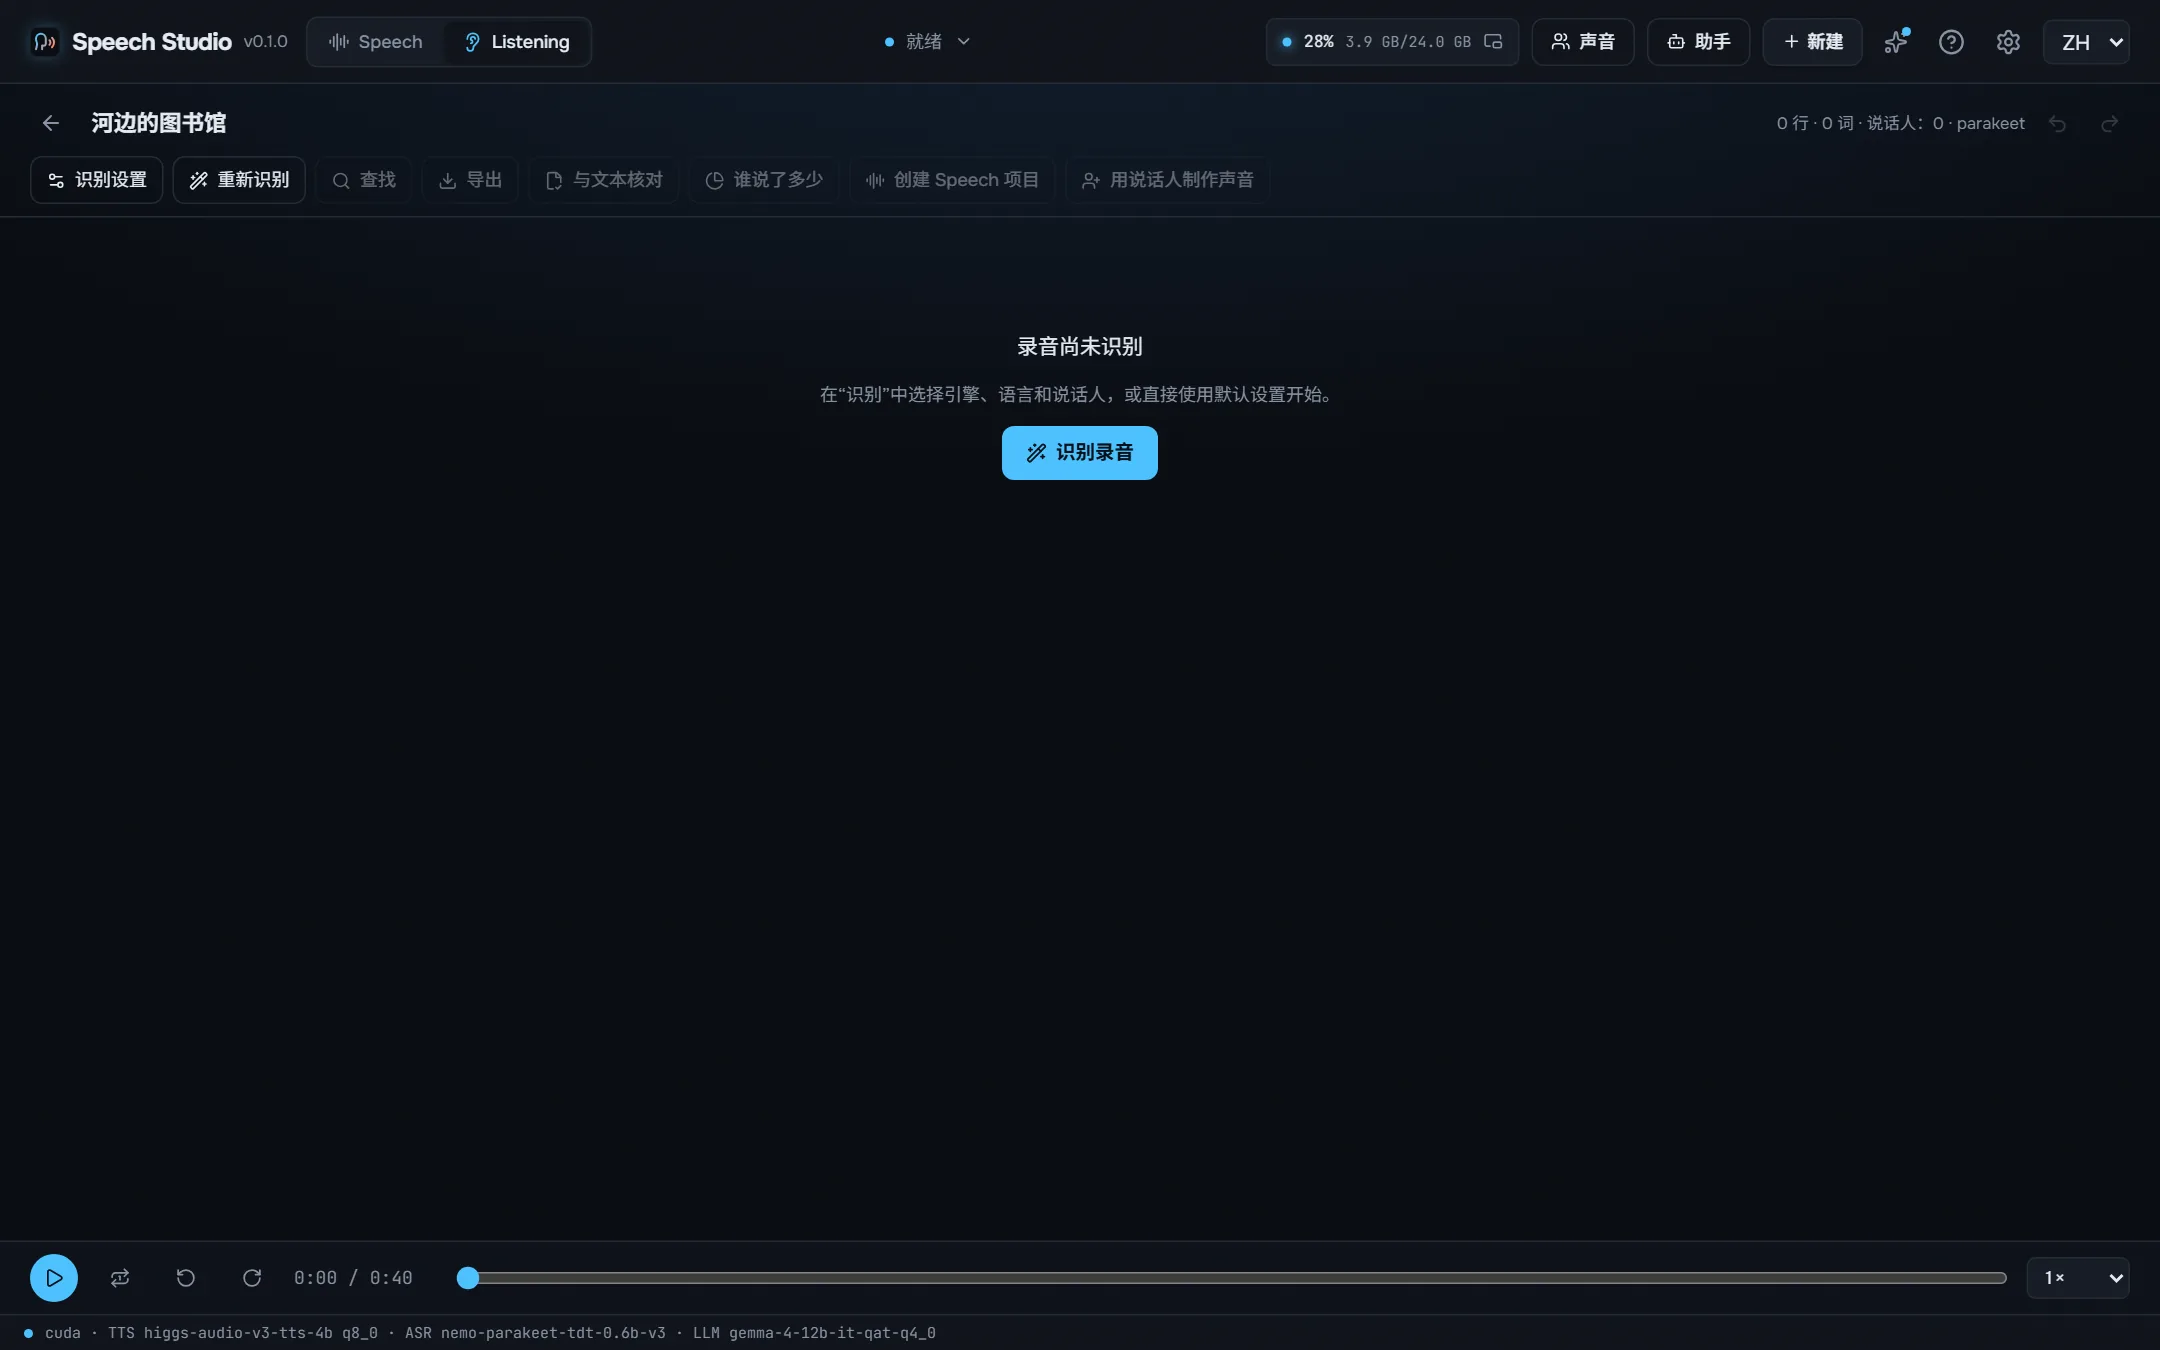
录音、视频或链接变成谁在何时说了什么的文字稿:Parakeet-TDT、Nemotron 3.5 或 Whisper,最多八位说话人,卡拉 OK 播放器,按文字剪辑,导出 SRT、VTT、ASS、TXT 或 JSON。
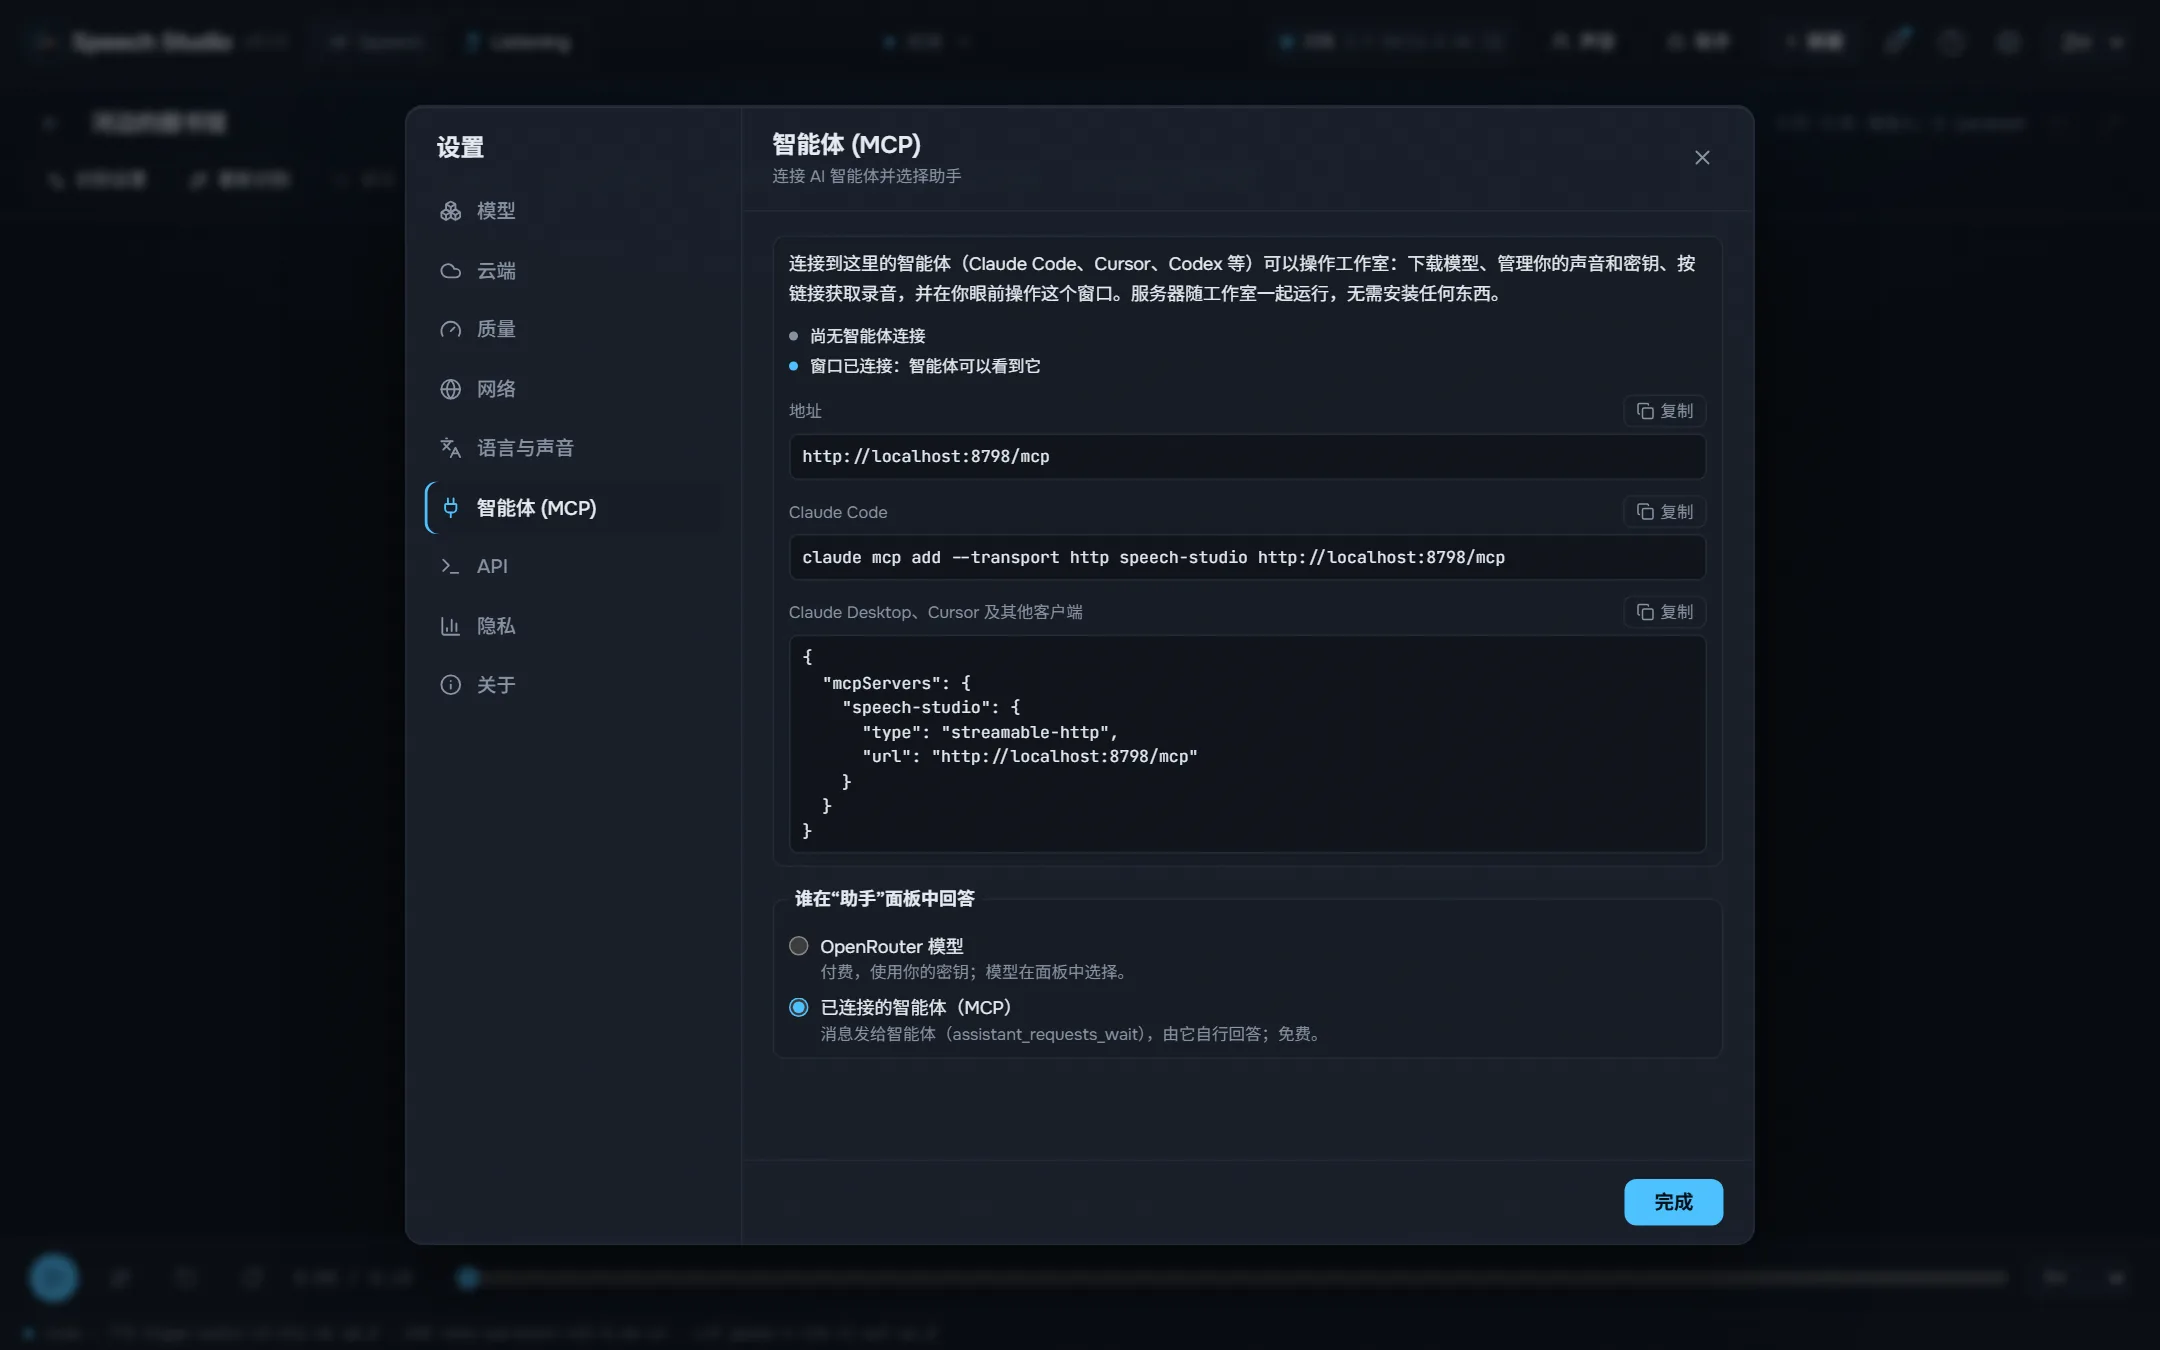
工作室打开时,Claude Code 或 Cursor 等智能体可以通过 MCP 完成窗口能做的一切:把文本配音成文件、编辑项目、分配声音、识别和检查录音。
工作室本身,使用你的语言。
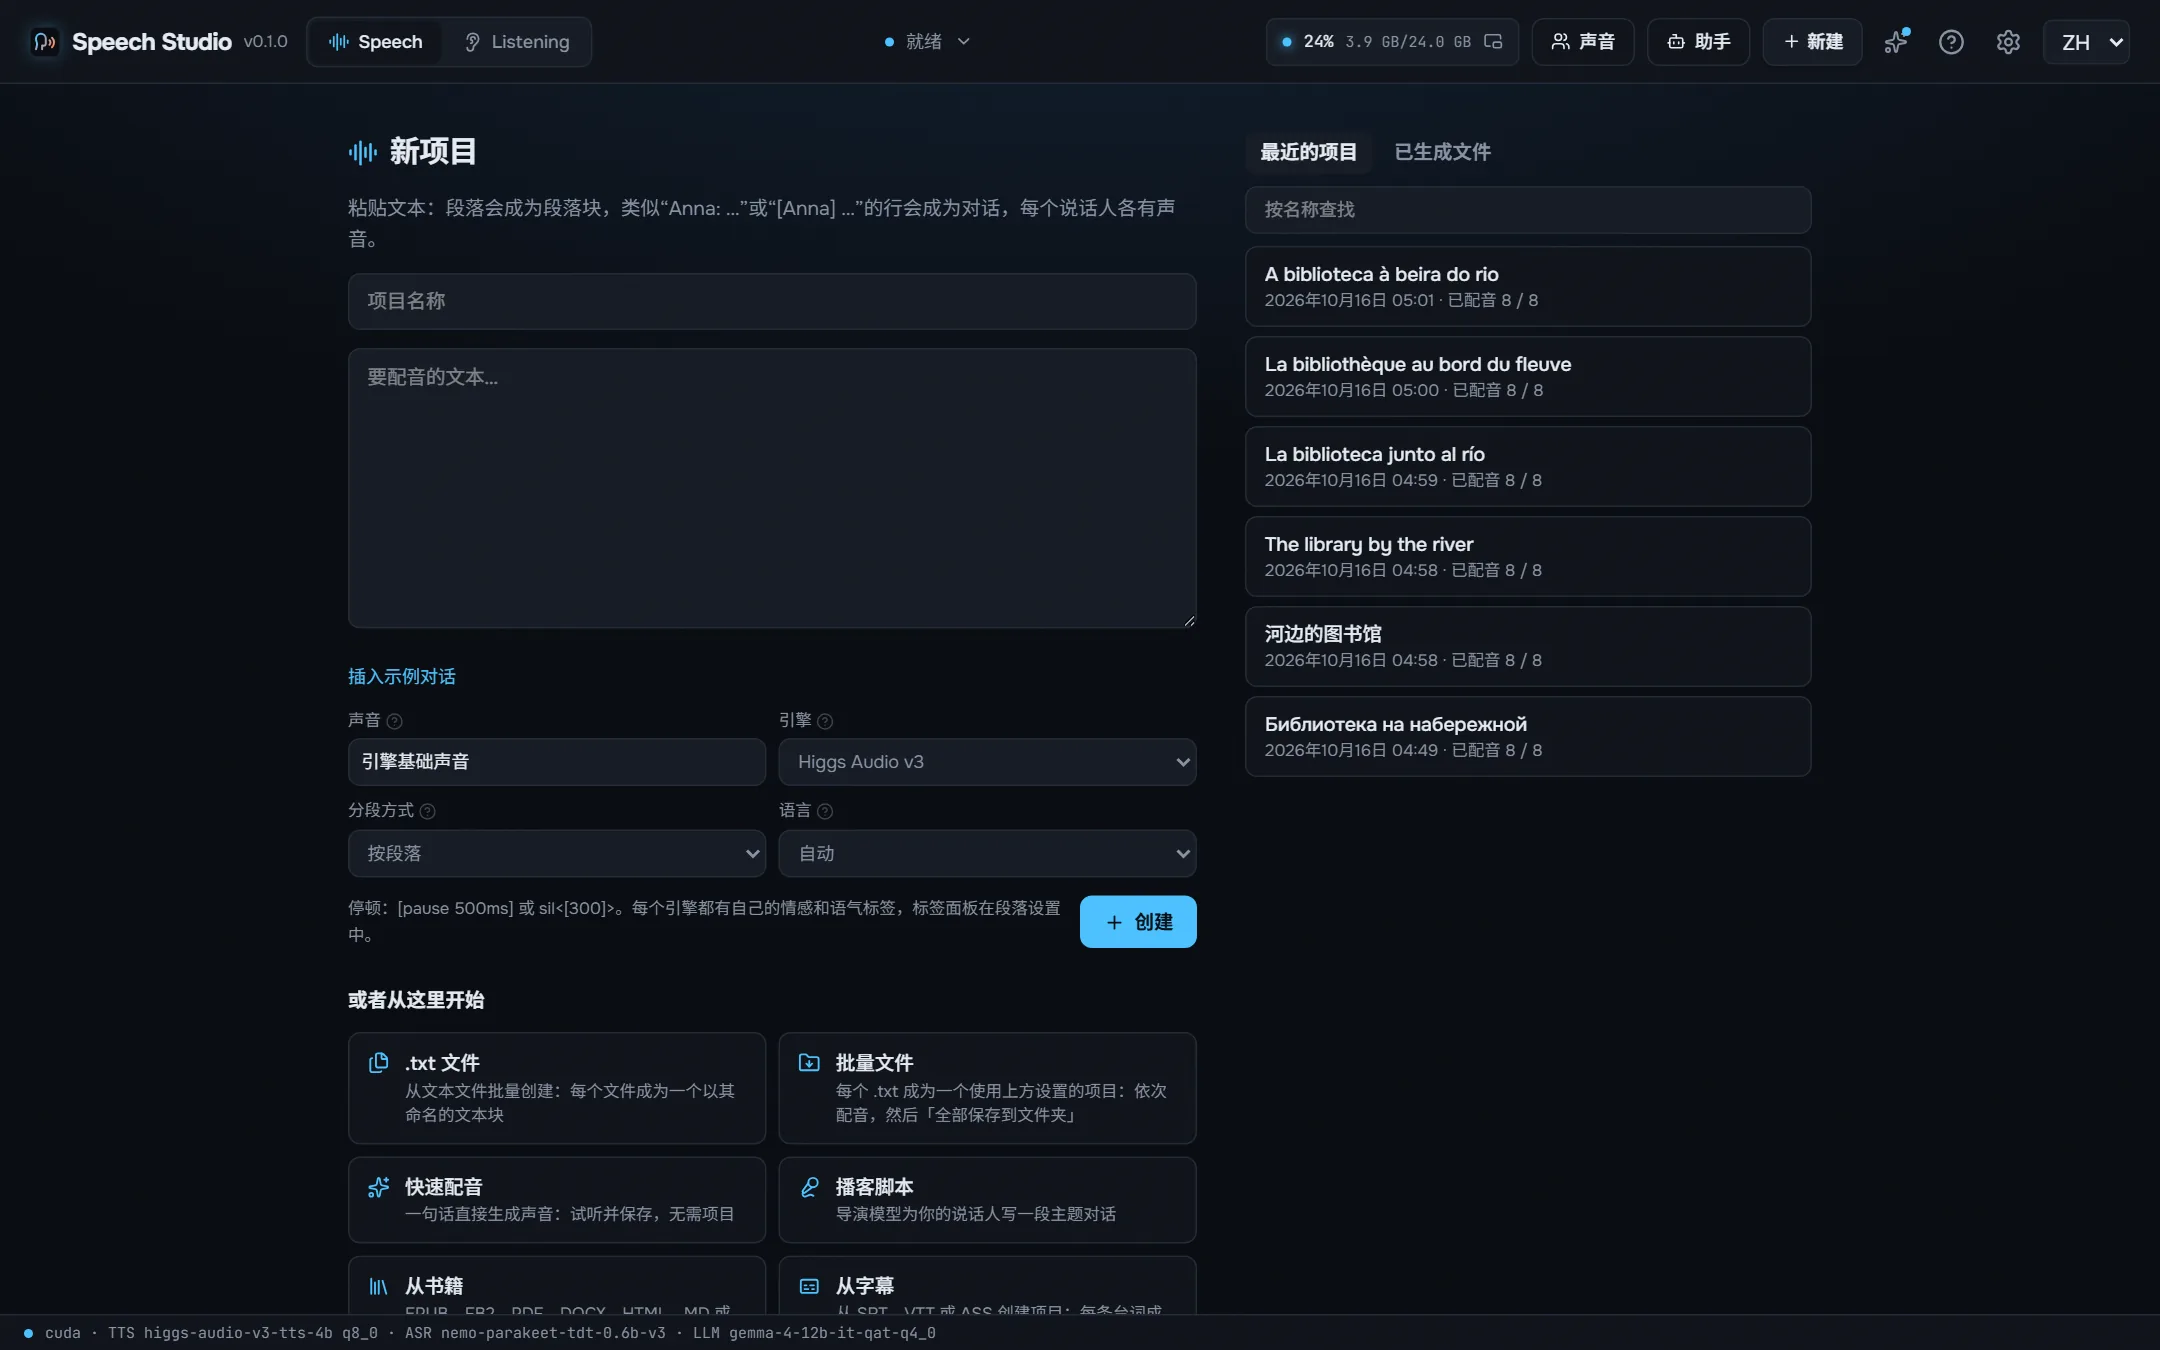
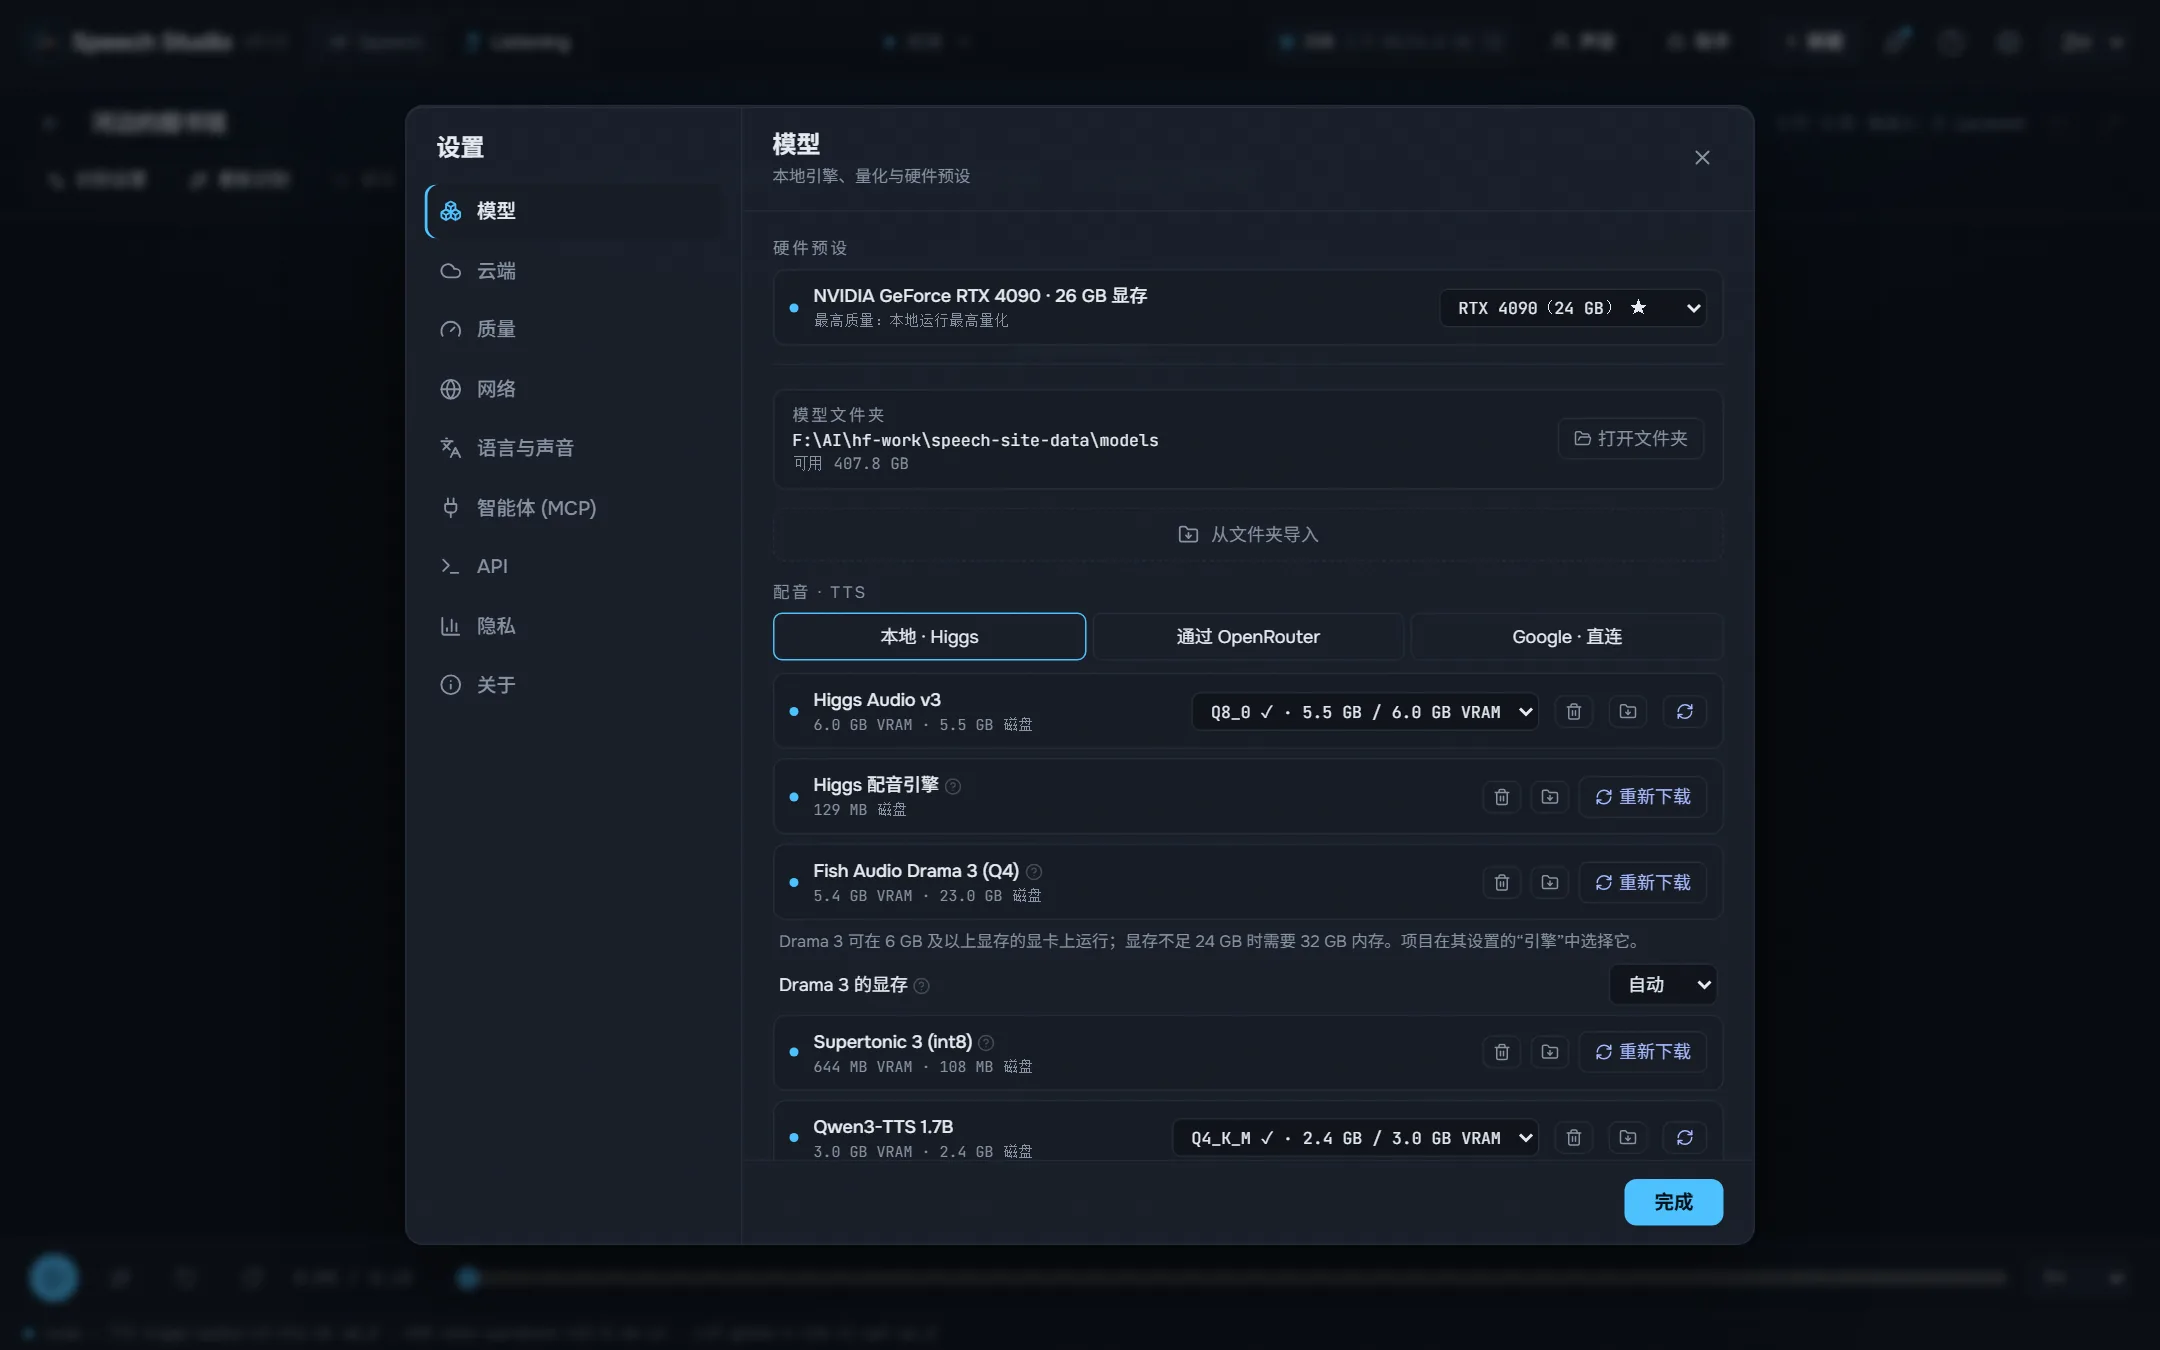
一块 8 GB 或更多显存、驱动较新的 NVIDIA 显卡。Drama 3 整体放入 24 GB;从 6 GB 起其专家放在内存中,此时需要 32 GB 内存。默认模型和引擎约占 9 GB 磁盘。
是的。工作室免费且开源,模型也可以在其中免费下载。
你的文本和录音属于你,并且留在你的磁盘上。
数字按正确的格和性、日期、时间、金额和单位在引擎朗读前写成单词。重音、«ё» 和同形异义词由 RUAccent 根据句子标注。
Supertonic 3 和 Qwen3-TTS 的俄语重音靠猜。工作室在引擎朗读之前标好重音:RUAccent 根据句子选择 замо́к 还是 за́мок、му́ки 还是 муки́,数字、日期和单位按正确的格写成单词。
工作室采用 MIT 许可。模型不是:每个模型保留自己的许可,列在 README 中。发布或出售配音作品前请先阅读。 README
工作室打开时,Claude Code 或 Cursor 等智能体可以通过 MCP 完成窗口能做的一切:把文本配音成文件、编辑项目、分配声音、识别和检查录音。为 OpenAI 音频编写的工具可通过其兼容 API 使用。
claude mcp add --transport http speech-studio http://127.0.0.1:8797/mcp
服务编译进桌面 exe,并通过 C ABI 在同一进程中运行引擎。运行时没有任何 Python 进程。
React UI ─┐
          ├─ Speech Studio.exe   (Tauri window + Rust/axum speech-server)
Rust axum ┘        │
                   ├─ Higgs Audio v3, Drama 3, Qwen3-TTS   (C++/CUDA, GGUF)
                   ├─ Parakeet, Nemotron 3.5   (transcribe.cpp, GGUF)
                   └─ Supertonic, RUAccent   (ONNX Runtime)